


PDF转TXT全是乱码?先判断是哪种PDF再动手
PDF转TXT乱码,3 秒版答案:先用记事本之外的方式判断——文字能选中就是文字版,转出来就正常;选不中就是扫描件,得走 OCR 路线,懒人办公的 PDF转TXT 工具会自动识别。往下看实测。
| 文字能选中复制 | 文字版PDF,直接转换即可 |
|---|---|
| 文字选不中、像图片 | 扫描件,需OCR识别路线 |
| 转换后中文变成问号 | 编码问题,改用UTF-8工具重转 |
| 只要某几页的文字 | 先提取页面再转TXT,省得整理 |
| 急用只有一页 | 复制粘贴到记事本应急 |
1方法一:用 Word 打开 PDF 重建文字
遇到 PDF转TXT乱码,机器上装了 Word 就先走这条路:Word 里 文件 → 打开 选中 PDF,Word 会自动把版面转成可编辑文档,转完 另存为 → 纯文本(.txt),编码选 UTF-8。
这条路的好处是版面还原度好,表格、分栏都能被拆清楚,顺手把乱七八糟的空行删了再存;但扫描件打开后还是一张张图片,文字出不来,那就直接换方法二。
2方法二:用懒人办公PDF转TXT在线提取
PDF转TXT乱码,不想折腾本地软件或者文件在别的机器上,用懒人办公的在线工具最直接:打开官网 www.lanren.work,进「PDF工具 → PDF转TXT」(直达 lanren.work/pdf/pdf-to-txt.html)。上传后自动提取文字,扫描件会走 OCR 识别。
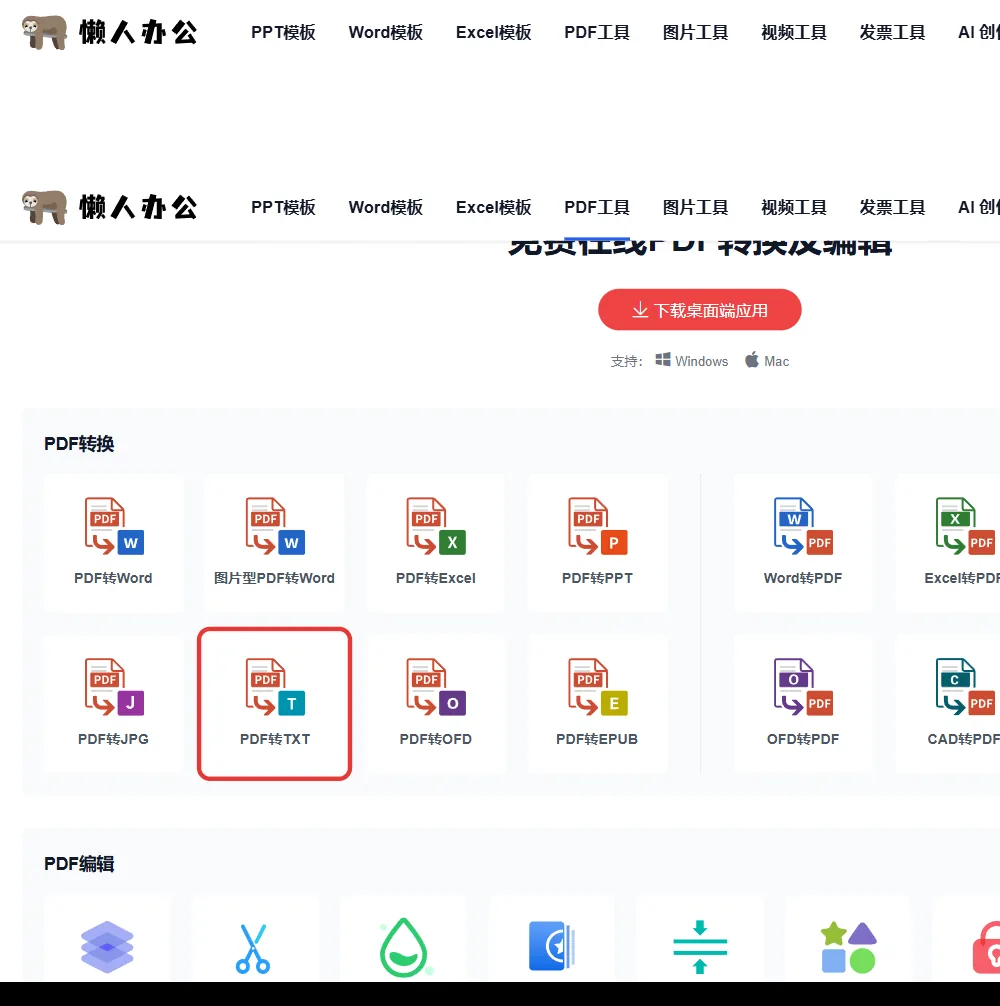
步骤 1:打开工具页,点「上传文件」把 PDF 传上去。
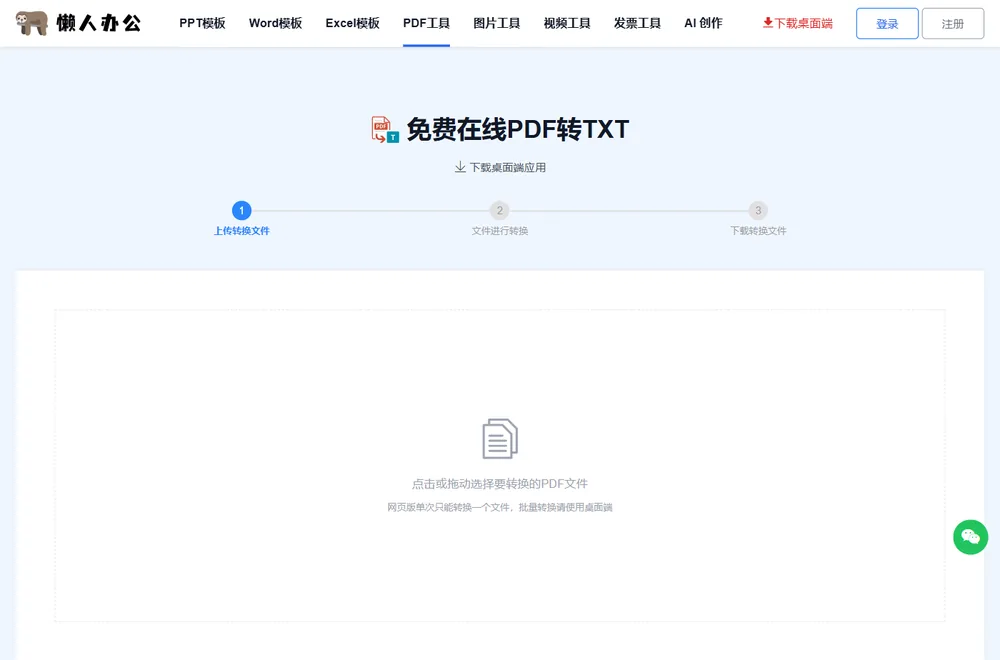
步骤 2:上传后自动开始提取,进度条走完即出结果。
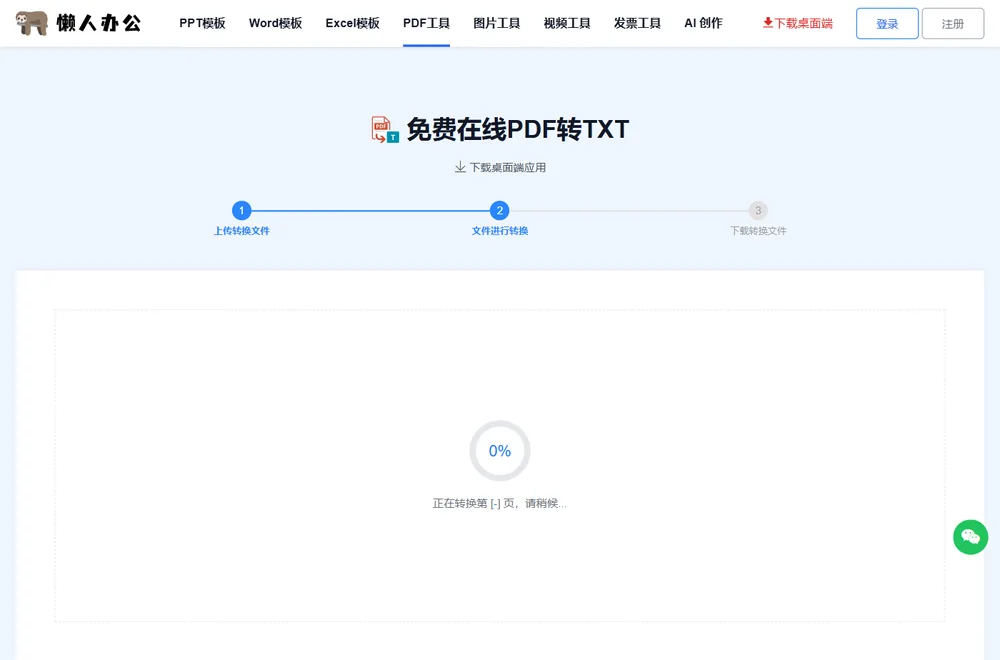
步骤 3:转换完成,点下载把 TXT 存到本地;如提示登陆,微信扫码关注公众号即可继续下载。
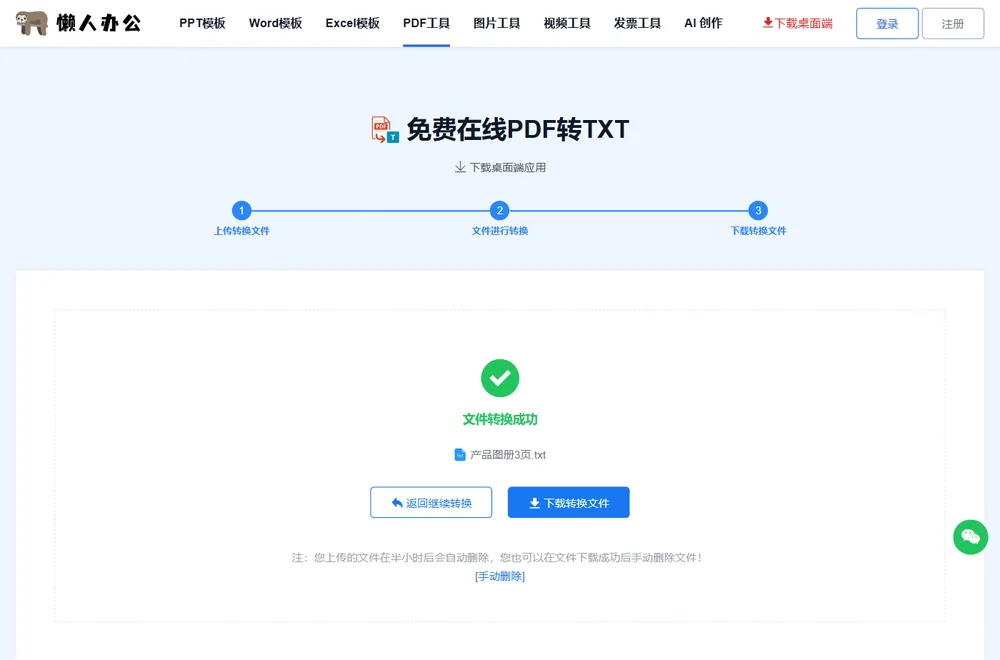
实测这份 3 页图册提出来的文字段落完整,没有出现问号和方块字;扫描的合同样本走 OCR 后正文也能整段复制,个别标点会认错,交给 OCR 后记得通读一遍。
3方法三:复制粘贴到记事本应急
PDF转TXT乱码,手头只有一两页急用,直接在阅读器里全选复制,粘到记事本里保存。文字版 PDF 这么做最快,粘完用记事本的查找替换清掉多余换行。
粘出来是乱码就别再试了,说明文件是扫描件或字体嵌入异常,老老实实走 OCR 路线,硬编辑只会越改越乱。
4三种方法优缺点对比,按场景对号入座
两种样本(文字版 + 扫描件)都验证过,优缺点放进一张表:
| 对比维度 | 方法一 Word打开 | 方法二 懒人办公PDF转TXT | 方法三 复制粘贴 |
|---|---|---|---|
| 优点 | 版面还原好,顺手可编辑 | 自动识别扫描件,整本一次提 | 零工具,一两页最快 |
| 缺点 | 扫描件无效 | 需要联网上传 | 页数多就累,编码不可控 |
| 适用场景 | 要顺手改内容再存 | 批量提取、扫描件 | 单页急用 |
- 只想转其中几页 → 先用 PDF提取页面 拆出来再转。
- 扫描件要转可编辑Word → 参考 扫描的PDF怎么转成可编辑Word。
- 转出来的TXT太大难传 → 打包压缩后再发,或直接分享在线链接。
- 常规转换流程没整明白 → 看 PDF怎么转成txt纯文本 的完整实测。
最后提醒:PDF转TXT乱码的根子多半在「拿扫描件当文字版转」,动手前先按一下 Ctrl+A 看能不能选中文字,选不中就果断走 OCR,能省一半折腾时间。
常见问题
PDF转TXT乱码后还能恢复原文字吗?
能。原 PDF 没被改动,换个路线重转就行:文字版换编码或换工具,扫描件走 OCR,原文件始终是兜底。
在线转换需要登录吗?
上传和转换直接进行,下载结果时如弹出登陆提示,微信扫码关注公众号即可继续,一次登陆全程可用。
怎么判断手里的 PDF 是不是扫描件?
在阅读器里试着选中文字:能选中复制的是文字版;选不中、放大后文字边缘发虚的是扫描件。或者看文件属性里有没有字体信息。
OCR识别的准确率怎么样?
印刷体正文识别很稳,段落顺序基本不乱;手写体、印章遮挡、竖排文字容易出错,转完务必通读核对,重点数字要跟原件对一遍。
为什么转换后英文正常中文是问号?
典型的编码问题,目标程序按错误编码读出了中文。把 TXT 用记事本另存为 UTF-8 编码再打开,或者直接换支持 UTF-8 输出的工具重转。
EPUB 里的文字也想提出来怎么办?
先把 EPUB 转回 PDF 再走同一条路线,或者直接在 EPUB 阅读器里复制;批量处理建议统一转 PDF 后用在线工具一次提完。
